OpenTSDB(Open time series data base),开发时间序列数据库。DB这个词很有误导性,其实并不是一个db,单独一个OpenTSDB无法存储任何数据,它只是一层数据读写的服务,更准确的说它只是建立在Hbase上的一层数据读写服务。行业内各种db都很多了,为什么还会出现它?它到底有什么好?它做了什么?别着急,我们来一一分析下。
其实OpenTSDB不是一个通用的数据存储服务,看名字就知道,它主要针对于时序数据。什么是时序数据,股票的变化趋势、温度的变化趋势、系统某个指标的变化趋势……其实都是时序数据,就是每个时间点上纪录一条数据。 关于数据的存储,我们最熟悉的就是mysql了,但是想想看,每5分钟存储一个点,一天288个点,一年就10万+,这还是单个维度,往往在实际应用中维度会非常多,比如股票交易所,成千上万支股票,每天所有股票数据就可能超过百万条,如果还得支持历史数据查询,mysql是远远扛不住的,必然要考虑分布式存储,最好的选择就是Hbase了,事实上业内基本上也是这么做的。(我对其他分布式存储不了解,就不对比了)。
了解Hbase的人都知道,它可以通过加机器的水平扩展迅速增加读写能力,非常适合存储海量的数据,但是它并不是关系数据库,无法进行类似mysql那种select、join等操作。 取而代之的只有非常简单的Get和Scan两种数据查询方式。这里不讨论Hbase的相关细节,总之,你可以通过Get获取到hbase里的一行数据,通过Scan来查询其中RowKey在某个范围里的一批数据。如此简单的查询方式虽然让hbase变得简单易用, 但也限制了它的使用场景。针对时序数据,只有get和scan远远满足不了你的需求。
这个时候OpenTSDB就应运而生。 首先它做了数据存储的优化,可以大幅度提升数据查询的效率和减少存储空间的使用。其次它基于hbase做了常用时序数据查询的API,比如数据的聚合、过滤等。另外它也针对数据热度倾斜做了优化。接下来挨个说下它分别是怎么做的。
数据存储优化
先解释下OpenTSDB用到的几个术语,方便大家理解。
metric: 指标,比如在系统监控中cpu mem的利用率、系统Load、IO等都是指标。
timestamp: 时间戳
tag: 标签,其实表示在哪个维度。 比如在cpu在某个机器上的数据,就可以把机器ip作为tag打进去。在OpenTSDB里tag是个k-v,比如 ip=192.168.0.1 就可以做为一个tag。注意OpenTSDB最多只能打8个tag。
value: 我们要存的时序数据的值。
如果我们只通过原始的Hbase接口去存时间序列,我们可能会设计出这样的Rowkey。
metric|timestamp|tagK1:tagV1|tagK2:tagV2...
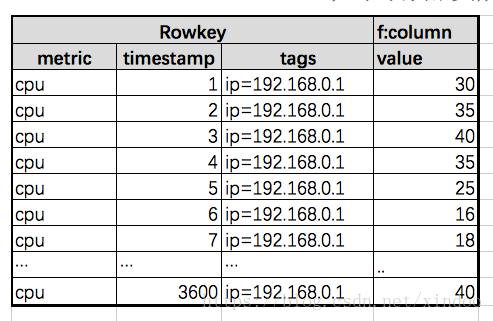
如果我们每秒存储一个数据点,每天就有86400个数据点,在hbase里就意味着86400行的数据,不仅浪费存储空间,而且还查起来慢,所以OpenTSDB做了数据压缩上的优化,多行一列转一行多列,一行多列转一行一列。数据开始写入时其实OpenTSDB还是一行一个数据点,如果用户开启了数据压缩的选项,OpenTSDB会在一个小时数据写完或者查询某个小时数据时对其做多行转一行的数据压缩,压缩后那些独立的点数据就会被删除以节省存储空间。
多行一列转一行多列
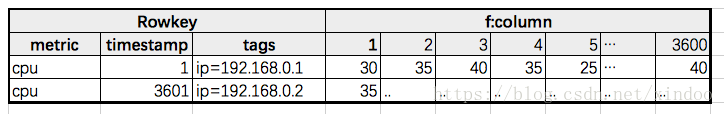
我们原始数据可能长这样,一个小时总共有3600行的数据。Opentsdb会将一个小时的数据合并到一个Rowkey里,相应的Rowkey里的timestamp也会归一化到哪个小时的时间戳。如下图。
通过这样转换后一个Rowkey就能查到一个小时的数据,一天24个Rowkey也就够了。在hbase中Qualifier是个两个Bytes的整数(如果是毫秒级数据是4个bytes),value是4-8 bytes的数值。
当每列不是存贮数值而是一个object的时候,Qualifier是3-5个bytes,然后第一个字节的开头16进制必须是0x01,用来标识存的是个对象而不是时序点(后续版本这个标识可能会变),后面两个byte用来表示这个object是哪个时间点,如果是毫秒级数据,后面就是4个bytes。里面的value是UTF-8编码的json串。
一行多列转一行一列
在2.2版本,opentsdb进一步对数据存储做了优化,把每个Row里的3600列合并成了一列,存储格式如下。
<offset1><value1><offset2><value2>...<offsetN><valueN>
就是位移量+值拼接在一起,opentsdb在这里并不要求这里的offset有序,查询的时候才会被排序。
Rowkey的优化
opentsdb在构建Rowkey的时候并不是直接用原始值的,而是将metric、timesta、tagk、tagv分别用了一个3字节的uid做了替代(3字节意味着最多1600多万uid,大多数情况下应该够用了),可以减少Rowkey的存储空间。所以这里需要有个表来做uid和真实值之间的转换,这个表就是tsdb-uid表。 UID表中有两个family,分别是uid-name的映射(name famlily),name-uid的映射(uid famliy)。另外还有一行特殊的数据,就是uid已分配情况记录表。
uid-name(id family)
Rowkey: uid
Qualifiers: metric, tagk, tagv
value: uid对应的实际name值
name-uid(name family)
Rowkey: name
Qualifiers: metric, tagk, tagv
value: name实际对应的uid值。
UID 分配行
这是一行非常特殊的数据,Rowkey为0x00,里面保存了metric、tagk、tagv已分配uid的最大值,每次新分配一个uid就会对其中相应的值增加1,这里用了hbase的原子操作,就是为了确保uid不重复。
数据查询
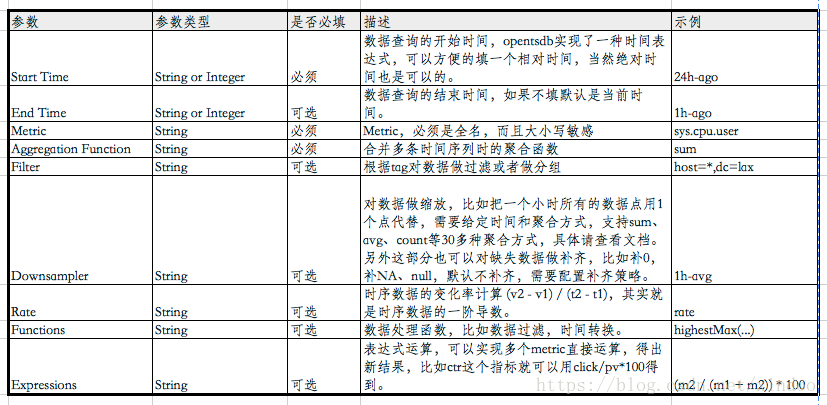
OpenTSDB对hbase的读做很多的封装,方便实现更复杂切灵活的查询功能,我们来看下读接口的查询参数就能一窥究竟。
OpenTSDB在从底层hbase拿到数据后数据处理流程如下。
Filtering       过滤
Grouping        分组
Downsampling    数据缩放
Interpolation   数据改写
Aggregation     聚合
Rate Conversion 计算斜率
Functions       执行函数
Expressions     表达式运算
数据热点之salting
用hbase存过数据的人可能会知道,大多数时候数据分布是存在严重倾斜的,可能20%的metric会聚集80%的数据,甚至更严重。因为hbase把数据按照Rowkey增序存储在不同的机器上,所以这种数据切斜很可能会导致hbase集群某些机器读写压力非常大,但别的机器却没什么压力。
为了解决数据热点的问题,OpenTSDB在2.2版本增加了对数据做分桶的能力。其实就是对每行数据的tags做hash,然后把hash值拼接到Rowkey前面,这样就可以使同metric产生的rowkey分散开,减少数据热点发生的可能性。 可以通过以下两个参数开启salting功能。
tsd.storage.salt.width     #桶宽度(说实话这个参数的意义我没理解)
tsd.storage.salt.buckets   #设置最大多少个bucket
有一点需要注意的,不要突发奇想去开关这个功能,这个集群要么从始至终开这个功能要么不开。否则你中途开关,会导致操作前的数据无法查询。 另外还有一点,开启salting会影响查询性能,比如你想扫某个metric下所有数据,这个时候就得遍历所有的bucket。
OpenTSDB其他特性
Metadata
OpenTSDB主要用来存储时序数据,且可以很方便地对数据做各种操作,但它也可以告诉我们里面存了一些什么样的数据,给我们提供一些数据的上下文。 具体见官方文档。
Tree
2.0版本提出了tree的概念,tree必须与metadata合用。大概就是将metadata里的信息按照各种规则将其转换为树形结构方便用户查看,类似计算机里的数据文件目录。具体见官方文档
各版本Feature列表
3.X (计划中)
- 分布式数据查询,通过分布式的方式提升数据查询吞吐量
- 查询caching,优化查询速度。
- 改进表达式 ,可以执行group by,数据缩放,随机修改。可能会支持udf。
- 异常检测预测
2.4 (计划中)
- Rollup/Pre-Aggregates - 支持时间序列数据在写入或者汇总的时候就做聚合,而不是等到查询在聚合。
- Distributed Percentile - Store histograms (or sketches) for calculating proper percentiles over multiple sources. (这个没怎么理解)
2.3
- 表达式计算,支持多个时序做计算,如ctr=click/pv*100
- Graphite Style Functions - Additional filtering and mutation of data at query time using Graphite style functions. (没理解)
- Calendar Based Downsampling - The ability to align downsampled data on Gregorian calendar boundaries.
- 支持google cloud的Bigtable做为数据存储
- 执行运行在Cassandra集群上
- 数据写入过滤
- 增加新聚合函数
- 执行metable的cache,提升查询性能
- 启动插件,帮助服务发现TSD启动
- 增加java示例
2.2
- 数据多列合并为一列,见上文详解。
- 随机metricid,提示分布式读写性能,见上文热点处理。
- 存储异常时的插件,当HBase不可用时,可以对数据点进行各种处理。
- 增加权限控制
- 缺失数据补全策略
- 新增 Count和Percentiles聚合函数
- 更多内部状态监控, 通过查询接口和线程、region client和JVM的新统计数据,深入地了解查询性能。
- 注释——通过/api//api/annotations接口扫描多个注释。
- 查询过滤
- 标签宽度支持配置化
- 数据压缩调优,新参数允许对TSD压缩过程进行调优。
- 支持删除数据和uid
- 支持同步写数据,确保数据能被写入hbase
- 查询状态的统计
2.1
- 支持数据缩放
- 支持查询某个时间片最后一个点
- Duplicates - Handle duplicate data points at query time or during FSCK
- FSCK - An updated FSCK utility that iterates over the main data table, finding and fixing errors
- 在单个tsd上批量申请uid做备用,而不是tsd每次有新数据就去申请uid。
- 增加UID Cache ,提升写入性能
2.0
- 无锁uid复制,提升了新metrics, tag names, or values的写入性能
- 对OpenTSDB所有的feature提供Restful API访问的方式,默认返回结果为json
- 支持跨域访问数据,以便ajax调用
- 支持通过http接口写入数据
- 支持配置文件
- 支持输入输出数据的序列化
- Annotations,记录特定时间序列或数据点的元数据。
- Meta Data
- Trees
- 支持搜索插件
- 支持实时数据publish插件,可以在数据写入tsd的时候立马发送出去
- 数据写入插件,能支持不同格式数据的写入
- 支持毫秒级数据
- 支持可变长度编码,减少数据占用的存储空间
- 支持查询对原始数据不做处理的查询
- 新增斜率计算
- 支持查看uid分配情况
Reference
- Opentsdb 官方文档http://opentsdb.net/docs/build/html/index.html