导语
同一份逻辑,不同人的实现的代码性能会出现数量级的差异; 同一份代码,你可能微调几个字符或者某行代码的顺序,就会有数倍的性能提升;同一份代码,也可能在不同处理器上运行也会有几倍的性能差异;十倍程序员 不是只存在于传说中,可能在我们的周围也比比皆是。十倍体现在程序员的方法面面,而代码性能却是其中最直观的一面。
本文是《如何写出高性能代码》系列的第二篇,本文将告诉你如何利用数据的几个特性以达到提升代码性能的目的。
可复用性
我们在代码中所用到的大部分数据,都是可以被重复使用的,这种能被重复使用的数据就不要去反复去获取或者初始化了,举个例子:
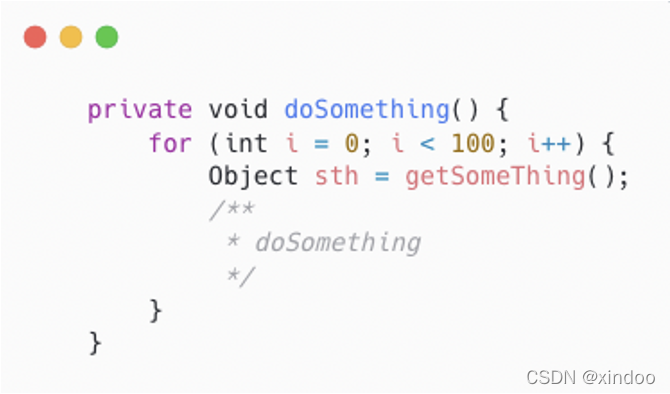
上图中在for循环中调用了getSomeThing()函数,而这个函数实际和循环无关,它是可以放在循环外,其结果也是可以复用的,上面代码放在循环内白白多调用了99次,这里如果getSomeThing()是个非常耗时或者耗CPU的函数,性能将会查近百倍。

在Java代码中,我们很常用的枚举类,大部分的枚举类可能经常有获取所有枚举信息的接口,大部分人可能写出来的代码像上面的getList()这样。然而这种写法虽然功能上没啥问题,但每调用一次就会生成一个新的List,如果调用频次很高就会对性能产生显著的影响。正确的做法应该静态初始化生成一个不可变的list,之后直接复用就行。
温馨提示:这里我特意标注了一个不可变,在对象复用的情况下需要额外关注下是否有地方会改变对象内容,如果对象需要被改变就不能复用了,可以deepcopy之后再更改。当然如果这个对象生来就是会被改变的,就没必要复用了。
非必要性
非必要性的意思是有些数据可能没必要去做初始化。举个简单的例子:
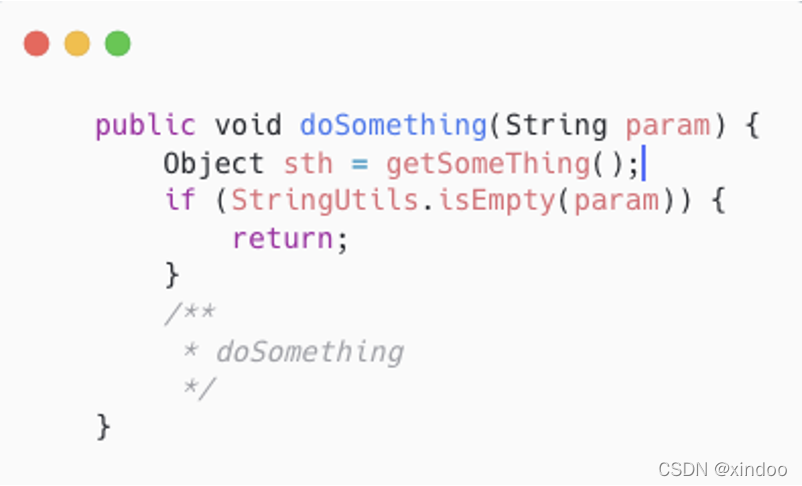
在上面代码中sth对象被获取后,才校验了参数的合法性,事实上如果参数是不合法的,sth就没必要初始化了,这里sth就具备了非必要性。类似上面这种代码其实很常见,我在我们公司代码库中就遇到了很多次,基本的模式都是先获取了某些数据,但在之后有些过滤或者检查的逻辑导致代码跳出,然后这些数据就完全没有用上。
应对非必要性的一个解决方案就是延迟初始化,有些地方也叫 懒加载 或者 惰性加载,像上面代码中只需要把getSomeThing()移动到参数校验的后面,就可以避免这个性能问题了。像Java中我们在用的checkstyle插件,就提供了一个VariableDeclarationUsageDistance 的规则,这个规则的作用强制让代码的声明和使用不会间隔太多行,从而避免出现上述这种声明但未使用导致的性能问题。
事实上,延迟初始化是一个非常常用的机制,比如著名的copy on write其实就是延迟初始化的典范。另外像Jdk中很多集合基本也都是延迟初始化的,就拿HashMap为例,你在执行new HashMap()时,只是创建了一个空壳对象,只有第一次调用put()方法时整个map才会初始化。
// new HashMap()只是初始化出来一个空壳hashmap
public HashMap(int initialCapacity, float loadFactor) {
    if (initialCapacity < 0)
        throw new IllegalArgumentException("Illegal initial capacity: " +
                                       initialCapacity);
    if (initialCapacity > MAXIMUM_CAPACITY)
        initialCapacity = MAXIMUM_CAPACITY;
    if (loadFactor <= 0 || Float.isNaN(loadFactor))
        throw new IllegalArgumentException("Illegal load factor: " +
                                       loadFactor);
    this.loadFactor = loadFactor;
    this.threshold = tableSizeFor(initialCapacity);
}

public V put(K key, V value) {
    return putVal(hash(key), key, value, false, true);
}

final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    // 第一次put触发内部真正的初始化
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    else {
       // 省略其它代码
    }
    ++modCount;
    if (++size > threshold)
        resize();
    afterNodeInsertion(evict);
    return null;
}
局部性
局部性也是老生常谈的特性了,局部性有好多种,数据局部性、空间局部性、时间局部性……可以说就是因为局部性的存在,世界才能更高效地运行。更多关于局部性的内容,可以参考下我之前写的一篇文章局部性原理——各类优化的基石。
这里先说下数据局部性,在大多数情况下,只有少量的数据是会被频繁访问的,俗称热点数据。处理热点数据最简单的方法就是给它加缓存加分片,具体方案就得看具体问题了。我来举个在互联网公司很常见的例子,很多业务数据都是存在数据库中,然而数据库在面对超大量的请求就有点力不从心了,因为局部性的存在,只有少量的数据是被频繁访问的,我们可以将这部分数据缓存在Redis中,从而减少对数据库的压力。
另外说个大家比较容易忽略的一点,代码局部性。系统中只有少量的代码是被反复执行的,而且如果系统有性能问题,也是少量的代码导致的,所以只要找出并优化好这部分代码,系统性能就能显著提升。依赖一些性能分析工具,比如用arthas火焰图就能很容易找到这部分代码(其他工具会在本系列第五篇文章中介绍)。
多读少写
除了局部性外,数据还有另外一个非常显著的特性,就是多读少写。这个也很符合大家的直觉和习惯,比如大部分人都是看文章而不是写文章,你到如何网站上也都是看的多,改的少,这是一条几乎放之四海而皆准的规律。 那这个特性对我们写代码有什么意义? 这个特性意味着大概率你的代码局部性就产生在读数据的代码上,额外关注下这部分代码。
当然也不是说写数据不重要,这里就不得不说到多读少写的另外一个特点了,那就是写的成本远高于读的成本,而且写的重要性也远高于读的重要性。 重要性不言而喻,去银行只是看不到余额可以接受,但取不了钱那肯定就是不行了。 那为什么写数据的成本会远高于读数据的成本呢? 简单可以这么理解,由于数据局部性的加持,很多读都可以通过各种手段来优化,而写就不大行,而且写可能会产生很多额外的副作用,需要添加很多校验之类的逻辑避免不必要的副作用。
以上就是本文的全部内容,希望大家有所收获。